
Com a evolução dos LLMs, uma pergunta aparece em quase toda conversa sobre planejamento: se o modelo já raciocina, ele ainda precisa de um motor de cálculo? Para sequenciamento de produção, decidimos testar em vez de opinar.
Entregamos a um LLM de fronteira os dados de uma fábrica real, com cerca de 4.500 ordens, e pedimos a programação completa, sem escrever código. Depois comparamos o plano dele com o do nPlan.
Resposta curta
Consegue fazer um plano válido. Não fez o melhor plano, e gastou um tempo e um custo que uma operação não tem para gastar.
O plano do LLM não quebrou nenhuma regra e chegou a ser melhor que as primeiras configurações do nPlan. O nPlan otimizado passou à frente: 27% menos setup, com o mesmo OTIF e praticamente o mesmo atraso, em 61 segundos contra 76 minutos.
Um LLM consegue fazer as contas de um sequenciamento. A questão é se deveria.
O lugar do LLM no planejamento não é fazendo as contas. É entendendo o que o planejador quer e chamando o motor que calcula.
O comparativo: melhor LLM contra nPlan otimizado
O nPlan otimizado fez 136 horas a menos de setup, com o mesmo OTIF medido no teste.
| Dimensão |  CLAUDEOpus 5.5 (LLM puro) |  NPLANSchedule (sem LLM) |
|---|---|---|
| Qualidade do plano | ||
| Regras quebradas | Nenhuma | Nenhuma |
| Setup total | 501 h | 365 h (−27%) |
| Trocas de setup | 3.438 | 2.806 (−18%) |
| Entrega | ||
| Ordens no prazo | 98,4% | 98,4% |
| Execução | ||
| Tempo para gerar o plano | 76 min | 61 s |
| Custo por execução¹ | cerca de US$ 25 | sem custo por execução |
| Mesmo plano a cada execução | Não | Sim |
Resultados deste teste · fábrica inteira, cerca de 4.500 ordens. ¹ O custo do LLM é estimado; a plataforma nPlan é paga por assinatura.
Por que 4.500 ordens e por que este modelo
Escolhemos uma base de 4.500 ordens porque é grande o bastante para expor as diferenças e pequena o bastante para testar com rigor.
Começamos por um teste básico, com um horizonte de apenas 120 ordens. Era simples e rápido, mas fácil demais: não deixava ver com clareza as diferenças, os desafios e o potencial de cada abordagem.
No outro extremo estão bases equivalentes às operações de grandes clientes, com 50 ou 100 mil ordens de produção. Com 4.500 ordens, o modelo já ocupou mais de 90% de sua janela de contexto; uma base dessa escala não caberia no mesmo formato. O tempo e o custo também cresceriam.
As 4.500 ordens ficam entre os dois. É o tamanho de um cliente real, ainda que não dos maiores, com um tipo de complexidade que se encontra em fábricas de verdade.
O modelo foi o Claude Opus 5.5, no esforço máximo. Este é um primeiro estudo, não a palavra final sobre o tema, e o Opus 5.5 combina alta capacidade com eficiência.
Modelos menores não faziam sentido: o objetivo era testar a fronteira do que um LLM consegue fazer.
A base: justa, mas não a mais difícil
A base tem as restrições que tornam o sequenciamento difícil na prática e deixa de fora outras que o tornariam muito mais difícil. Os dados são de um cliente real, anonimizados: sem nomes, códigos ou produtos, com tamanhos arredondados e datas deslocadas.
Os dados desta fábrica também ajudam. Sobra máquina: a carga total ocupa pouco mais de um terço de uma semana, e o gargalo são os moldes. Quase todos os moldes atendem um só grupo de máquinas, e 9 em cada 10 ordens vencem mais de uma semana depois do fim do plano.
Com várias operações por ordem, restrição de material ou de operador, o problema seria bem mais difícil. É o que se encontra em muitas fábricas reais.
Como foi o teste
Os dois lados receberam o mesmo problema e o mesmo objetivo. A diferença estava no método: o LLM teve de resolver tudo por inferência, sem escrever código.
O LLM recebeu uma instrução com o cenário da fábrica e todas as restrições que o plano precisava respeitar. A instrução proibia gerar código: o modelo deveria raciocinar e escrever o plano diretamente, sem criar nenhum programa para executar. O registro da execução confirma que ele seguiu essa regra.
Ele devolveu, para cada ordem, a máquina, o molde e os horários de setup, início e fim, numa única tentativa.
O objetivo foi o mesmo para os dois, nesta ordem: programar todas as ordens sem quebrar regra, ter o menor atraso total e, por último, o menor setup total.
O nPlan avança de evento em evento: quando uma máquina fica livre, escolhe a próxima ordem pelos critérios configurados e confere a escolha contra todas as restrições antes de gravá-la. Por isso é rápido e devolve sempre o mesmo plano para os mesmos dados. Rodamos o nPlan em quatro configurações. Na última, um algoritmo otimiza automaticamente os parâmetros da regra de sequenciamento.
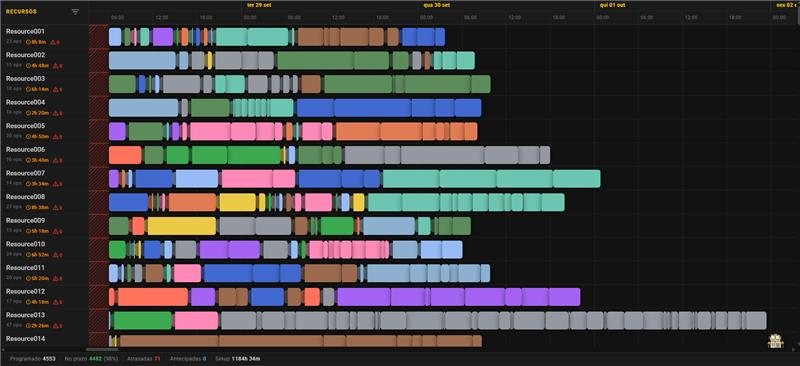
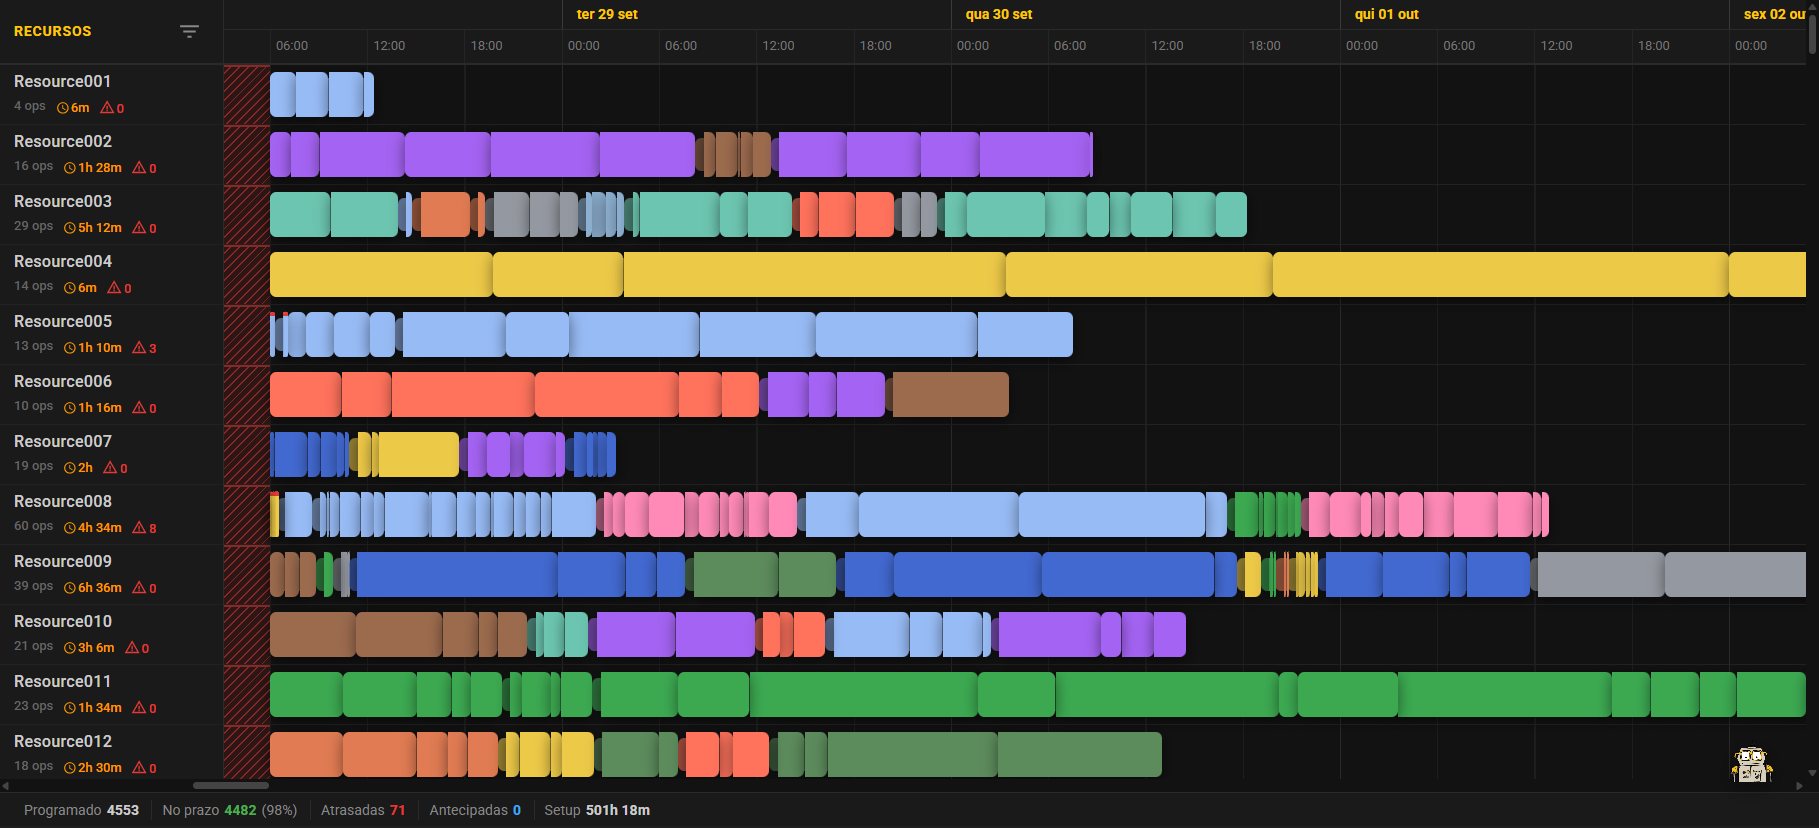
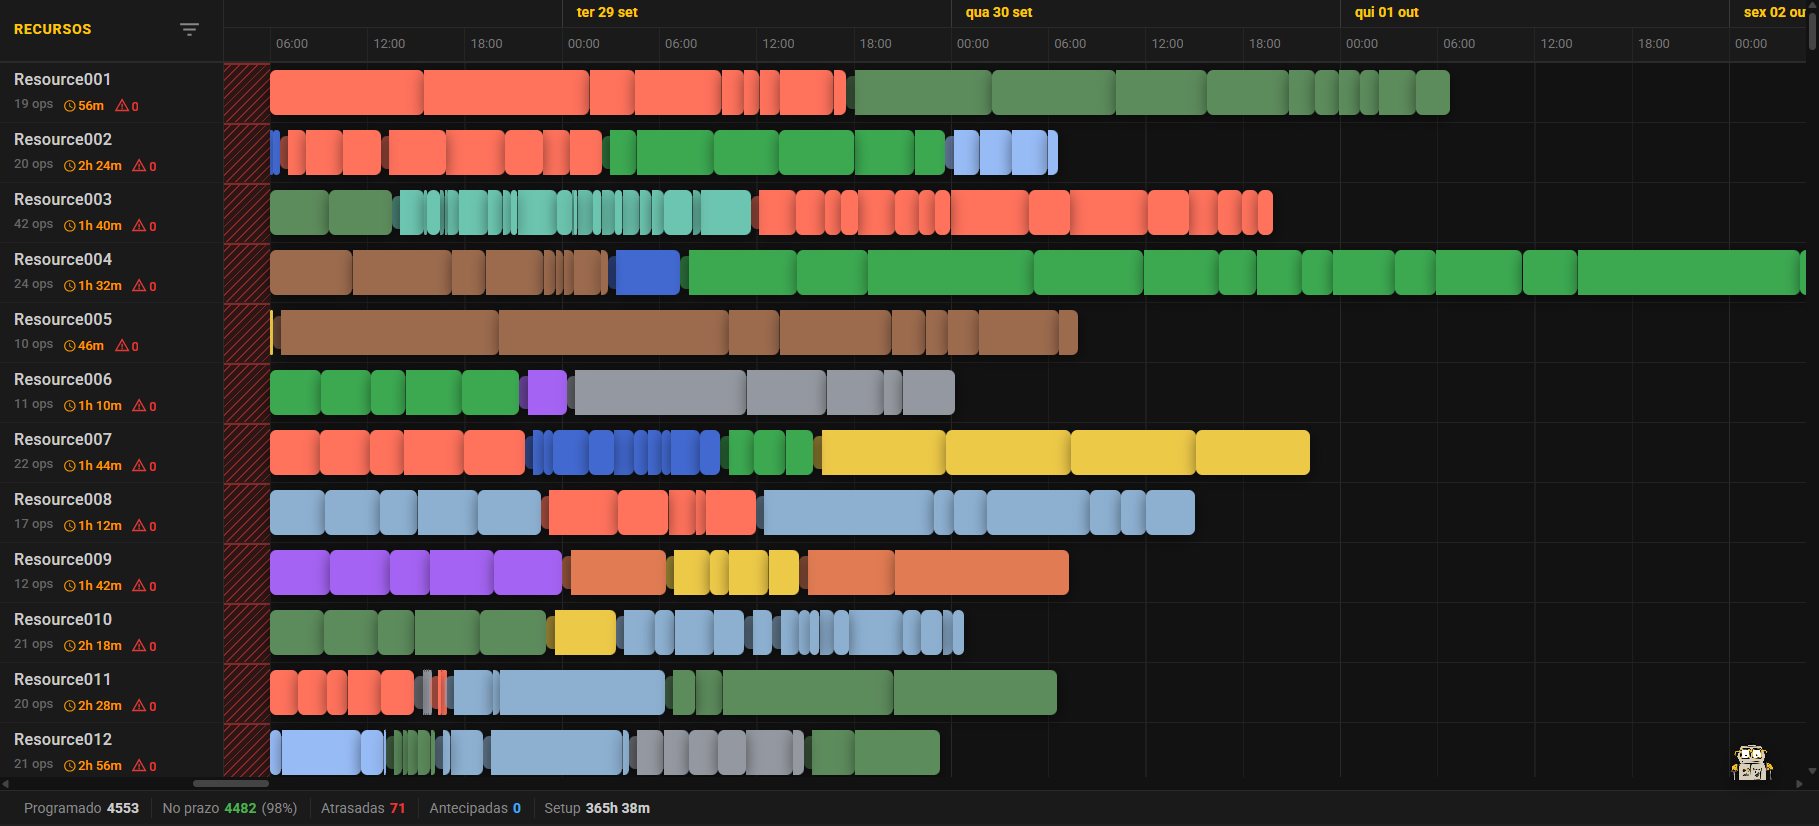
Os três planos abaixo cobrem a mesma janela e as mesmas máquinas. Cada cor é uma família de produto, e cada troca de cor é um setup longo.
O juiz: os dois planos são executáveis
Os dois planos passaram em todas as verificações: zero regras quebradas, em todas as ordens.
Um plano com pouco setup não vale nada se não puder ser executado.
Por isso, antes de comparar qualquer resultado, carregamos o plano do LLM no Gantt do nPlan e rodamos a mesma checagem aplicada ao plano do motor, ordem a ordem, com tolerância de meio minuto. Ela confere que:
- nenhum molde está em duas máquinas ao mesmo tempo;
- nenhuma ordem roda com a fábrica parada, na troca de turno ou no fim de semana;
- cada ordem tem a duração correta;
- cada setup tem o tempo certo para a sequência, conforme muda a família ou só o atributo;
- nenhuma ordem começa antes da data mais cedo permitida.
Antes, testamos o próprio juiz: ele aprova o plano do motor e aponta três erros plantados de propósito. Um segundo verificador, escrito só a partir do texto do problema e sem nenhum código do motor, refez todas as contas e chegou ao mesmo veredito.
Resultado: menos setup, mesmo atraso
Com os dois planos válidos, a diferença ficou no setup: 365 horas no nPlan otimizado, contra 501 no LLM.
São 136 horas de máquina a menos em troca, em pouco mais de dez dias de plano. O nPlan chegou lá com 632 trocas a menos, agrupando melhor as ordens de cada família.
O OTIF medido foi de 98,4% em ambos os planos.
Fazer um plano válido não é o mesmo que fazer o melhor plano.
Como o nPlan passou à frente
O LLM venceu as três primeiras etapas de configuração do nPlan. Só a configuração com otimização automática dos parâmetros da regra de sequenciamento passou à frente.
A primeira etapa é um sequenciamento para frente, sem otimização: o motor pega a próxima ordem que pode rodar, sem olhar o setup. As duas seguintes são etapas intermediárias, que passam a priorizar o menor setup e a olhar mais longe no horizonte. Na configuração final, um algoritmo otimiza automaticamente os parâmetros da regra de sequenciamento do nPlan para reduzir o setup.
Comparando os planos máquina a máquina, o motivo apareceu. Nas etapas intermediárias, o nPlan trocava de família a toda hora e deixava máquinas paradas à espera de moldes em uso em outras máquinas. O LLM fazia o contrário: deixava cada molde numa máquina e agrupava as ordens por família.
A otimização automática dos parâmetros dessa regra resolveu isso. O nPlan otimizado deixou 98% dos moldes numa única máquina, contra 90% no plano do LLM e 79% na etapa anterior.
Por que o LLM foi bem
O LLM foi bem porque encontrou uma forma de quebrar o problema: com máquina sobrando, prendeu cada molde numa só máquina.
Assim o molde nunca precisa estar em dois lugares ao mesmo tempo, e a regra mais difícil, a que cruza máquinas, vira uma questão de sequência dentro de cada máquina. Depois bastou ordenar as ordens de cada máquina por família. A estratégia funciona porque esta base tem as simplificações descritas acima.
Ao entregar, o próprio modelo descreveu o que fez:
“Programei cada ordem à mão. Cada ferramenta fica numa máquina escolhida do seu grupo (ou só muda depois que o uso anterior terminou); as ordens foram postas uma atrás da outra na primeira janela de trabalho e ordenadas por atributo para cortar setups, e as poucas ordens com prazo urgente foram colocadas primeiro nas suas máquinas […]”
Claude Opus 5.5, ao entregar o plano
Tempo e custo: o que muda na operação
A diferença entre 61 segundos e 76 minutos não é só de velocidade. É a diferença entre gerar um plano e conseguir simular.
Sequenciamento não se roda uma vez por mês. Uma máquina para, um pedido muda, um fornecedor atrasa, e o plano precisa ser refeito, às vezes mais de uma vez por dia.
Em um minuto, o planejador testa hipóteses: liga um terceiro turno e vê o efeito, muda um parâmetro e compara. Em 76 minutos, cada pergunta vira uma espera, e a maior parte delas deixa de ser feita.
Um plano que leva 76 minutos não é simulação. É espera.
Uma conta simples, com os números deste teste:
| Cenário | Claude Opus 5.5 | nPlan |
|---|---|---|
| Simular 10 cenários · tempo acumulado | 12,7 h | 10 min |
| Simular 10 cenários · custo por execução | US$ 250 | sem custo por execução |
| Replanejar 3 vezes por dia, por 22 dias úteis · tempo acumulado | 83,6 h | 67 min |
| Replanejar 3 vezes por dia, por 22 dias úteis · custo por execução | US$ 1.650 | sem custo por execução |
Conta ilustrativa com os tempos deste teste e o custo estimado do LLM.
O custo do LLM é uma estimativa pela API, a preço de tabela: cerca de US$ 25 por execução. O registro mostra um piso de US$ 12, mas não traz todo o texto que o modelo gerou para raciocinar. No nPlan, cada execução é “grátis”: paga-se a plataforma, não cada vez que se aperta o botão.
Há também a repetição. Para medir o efeito de um terceiro turno, o plano precisa mudar só por causa dele. O motor devolve o mesmo plano para os mesmos dados; se o plano do LLM mudar a cada execução, não há como saber se a diferença veio do turno ou do modelo.
E há o tamanho. Com 4.500 ordens, o modelo terminou ocupando cerca de 903 mil tokens, 90% do seu limite de contexto. Bases equivalentes a operações de grandes clientes, com 50 a 100 mil ordens, não caberiam do mesmo jeito.
Limites deste teste
Este é um primeiro estudo, com um único modelo, uma única fábrica e um único tamanho de problema. Ele vai amadurecer com o tempo, com novos modelos, bases maiores e restrições mais complexas. Para ler os resultados, vale ter em mente:
- O nPlan teve quatro configurações, e a final foi definida depois de vermos o plano do LLM. O LLM teve uma tentativa, sem retorno sobre o plano; com uma segunda, talvez melhorasse.
- Nós preparamos o problema: convertemos os dados em texto, explicamos as regras e anonimizamos tudo. O LLM não leu o banco de dados nem descobriu as regras sozinho.
- É um plano estático, sem quebras de máquina, eventos ou replanejamento.
- O custo do LLM é uma estimativa a preço de tabela da API.
- A versão do LLM que escreve e executa código ficou de fora. Num teste anterior, com problemas sintéticos, ela venceu o motor. Quando escreve código, o LLM deixa de fazer as contas à mão e passa a construir um motor: a pergunta vira se esse motor deve ser reescrito a cada execução ou testado e mantido.
Quer ver o mesmo teste com os dados da sua fábrica? Estamos abertos a provas de conceito com empresas interessadas. Fale com a gente.
Então, consegue?
Consegue fazer um plano válido para uma fábrica real, sozinho e sem código. Só isso já é um resultado interessante.
Mas o nPlan otimizado não foi só melhor. Fez 27% menos setup com o mesmo atraso, em um minuto em vez de 76, sem custo a cada execução e sempre com o mesmo resultado. E esta fábrica ainda é mais simples do que muitas outras.
Por isso, a arquitetura que faz sentido não é o LLM no lugar do motor. É o LLM na frente do motor: ele interpreta o que o planejador quer, chama o motor como ferramenta e explica o resultado.
Na prática, o planejador pergunta o que acontece se abrir um terceiro turno na semana que vem. O LLM ajusta o calendário, roda o nPlan, compara os dois cenários e responde em linguagem natural, em minutos. O próprio teste mostrou esse papel: foi comparando o plano do LLM com o do motor que encontramos a configuração final.
O LLM não precisa fazer as contas sozinho. Com um motor para chamar, ele planeja de forma mais rápida, barata, auditável e confiável.
Testes mais elaborados vêm a seguir: bases maiores, ordens com várias etapas, restrição de material e de operador, replanejamento com eventos. Este primeiro estudo já mostra o essencial: é na combinação com o motor que o LLM rende mais no sequenciamento.